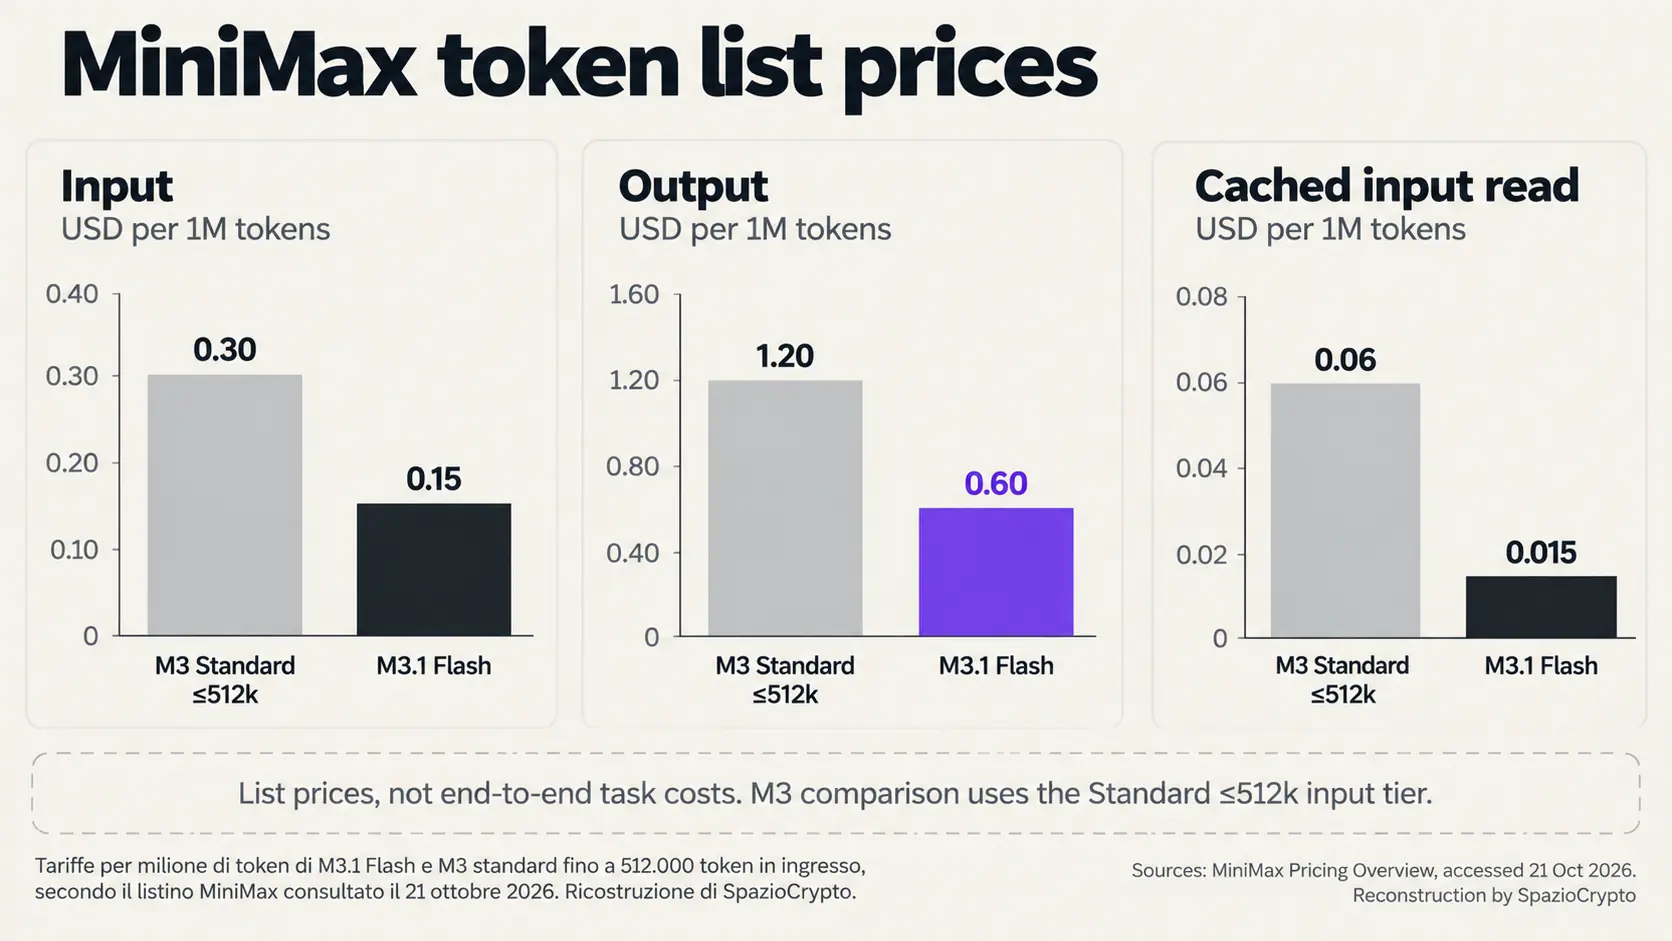
MiniMax는 2026년 10월 19일 MiniMax M3.1 Flash를 출시하며 입력 토큰 100만 개당 0.15달러. 출력 토큰 100만 개당 0.60달러의 가격표를 공개했다. 모델은 현재 API를 통해 이용 가능하며, 가중치(weights)는 추후 공개될 예정이다. 에이전트 및 소프트웨어를 개발하는 이들에게 주목할 변화다. 단위 가격은 낮아졌지만, 실제 작업 비용은 시스템이 얼마나 추론하는지, 어떤 도구를 쓰는지, 몇 번의 수정이 필요한지에 따라 달라진다.
가격표는 두 항목을 절반으로 줄였다, 청구서 전체가 아니라
공식 가격 페이지에서 직접 비교가 가능하다. 입력 토큰 51만 2,000개 이하 표준 구간에서 MiniMax M3는 입력 100만 개당 0.30달러, 출력 100만 개당 1.20달러다. Flash는 이 두 항목을 모두 절반으로 낮췄다. 캐시 읽기 요금은 100만 개당 0.06달러에서 0.015달러로 인하됐다. 이 항목들은 별도로 청구된다. 캐시 요금은 재사용 가능한 것으로 인식된 토큰에만 적용되며, 전송된 모든 데이터에 일괄 적용되지 않는다.
MiniMax 공식 발표에 따르면, 에이전트 작업의 전체 비용이 전작 대비 70% 절감된다고 명시했다. 이 수치는 두 주요 요금 항목을 절반으로 줄인 것과 단순히 일치하지 않는다. 토큰 소비 방식이나 작업 완료 방식의 차이가 포함될 수 있지만, 모든 고객에게 동일한 절감 효과를 보장하지는 않는다. 자동화 시스템 도입을 검토할 때, 검증 가능한 공시 요금과 실제 운영 결과를 구분하는 것이 중요하다.
구체적인 예시로 차이를 살펴보자. 표준 구간 기준, 입력 토큰 100만 개와 출력 토큰 10만 개를 캐시 없이 사용한다고 가정하면, Flash로는 0.21달러, M3 표준으로는 0.42달러가 된다. 이는 동일한 가상 소비량을 전제로 한 자체 계산이며 참고용이다. 추가 API 호출, 도구 사용, 사람의 개입은 포함되지 않는다. 에이전트가 특정 단계를 반복하거나 더 많은 추론을 생성하면, 단위 가격이 동일하더라도 청구 토큰 수는 달라진다.
추론에는 끄기 옵션이 없다, 조절만 가능하다
Anthropic 호환 인터페이스 문서에는 low부터 max까지 다섯 단계의 추론 레벨이 정의되어 있다. M3.1 Flash에서는 파라미터를 생략하면 max가 기본값으로 설정된다. 적응형 추론은 비활성화 값을 지정해도 실제로 꺼지지 않으며, 문서에 따르면 해당 요청에 오류가 반환된다. 기존 설정을 재사용하는 통합 환경에서는 새 모델이 실제로 지원하는 동작을 별도로 확인해야 한다.
같은 문서에 따르면, 추론 레벨을 높이면 추론 토큰이 늘어나고 응답 지연도 증가할 수 있다. 토큰당 가격과 전체 응답 시간은 서로 다른 차원의 지표다. 유의미한 테스트를 위해서는 목표, 도구, 수락 기준을 동일하게 유지하고 선택한 레벨을 명확히 기록해야 한다. 그렇지 않으면 빠른 응답과 더 깊은 추론 결과를 이유도 모른 채 비교하는 오류가 생긴다.
MiniMax M3.1 Flash: Space Performance + Bunny Speed 🚀🐰 Yes, Space Bunny - which has topped global leaderboards with 200T+ tokens - was an earlier version of M3.1 Flash. 💰Redefining the performance economics of agentic AI. M3.1 Flash achieves frontier-level intelligence across key tasks such as Cowork (Automation-Bench: 62%; ALE: 30%), Coding (DeepSWE: 74%) and Visual Reasoning (BabyVision: 91%), at 1/3 the cost of M3 and 3x the speed. API pricing (flat rate): $0.15 / $0.60 per 1M input/output tokens, with cache reads at $0.015 / 1M tokens. Model weights will arrive on Oct 23. API: https://t.co/fHRdSV73Hr M Plan: https://t.co/XfJWSyauda MiniMax Code for desktop: https://t.co/SGmLTI2HQm
, MiniMax (official) (@MiniMax_AI) October 19, 2026
공식 카탈로그에는 100만 토큰의 컨텍스트 창과 멀티모달 기능이 명시되어 있다. 다만 선언된 용량이 모든 긴 문서를 올바르게 처리한다는 보장은 아니다. API로 모델을 통합하는 개발자라면, 각 단계 사이에 필요한 정보를 유지하는 방법이 핵심 과제다. 매우 큰 요청에는 불필요하거나 상충하는 지시가 포함될 수 있다. 요청을 수용할 수 있다는 사실이 모델이 항상 올바른 정보를 선택한다는 의미는 아니다.
벤치마크는 제한된 조건의 측정값이다
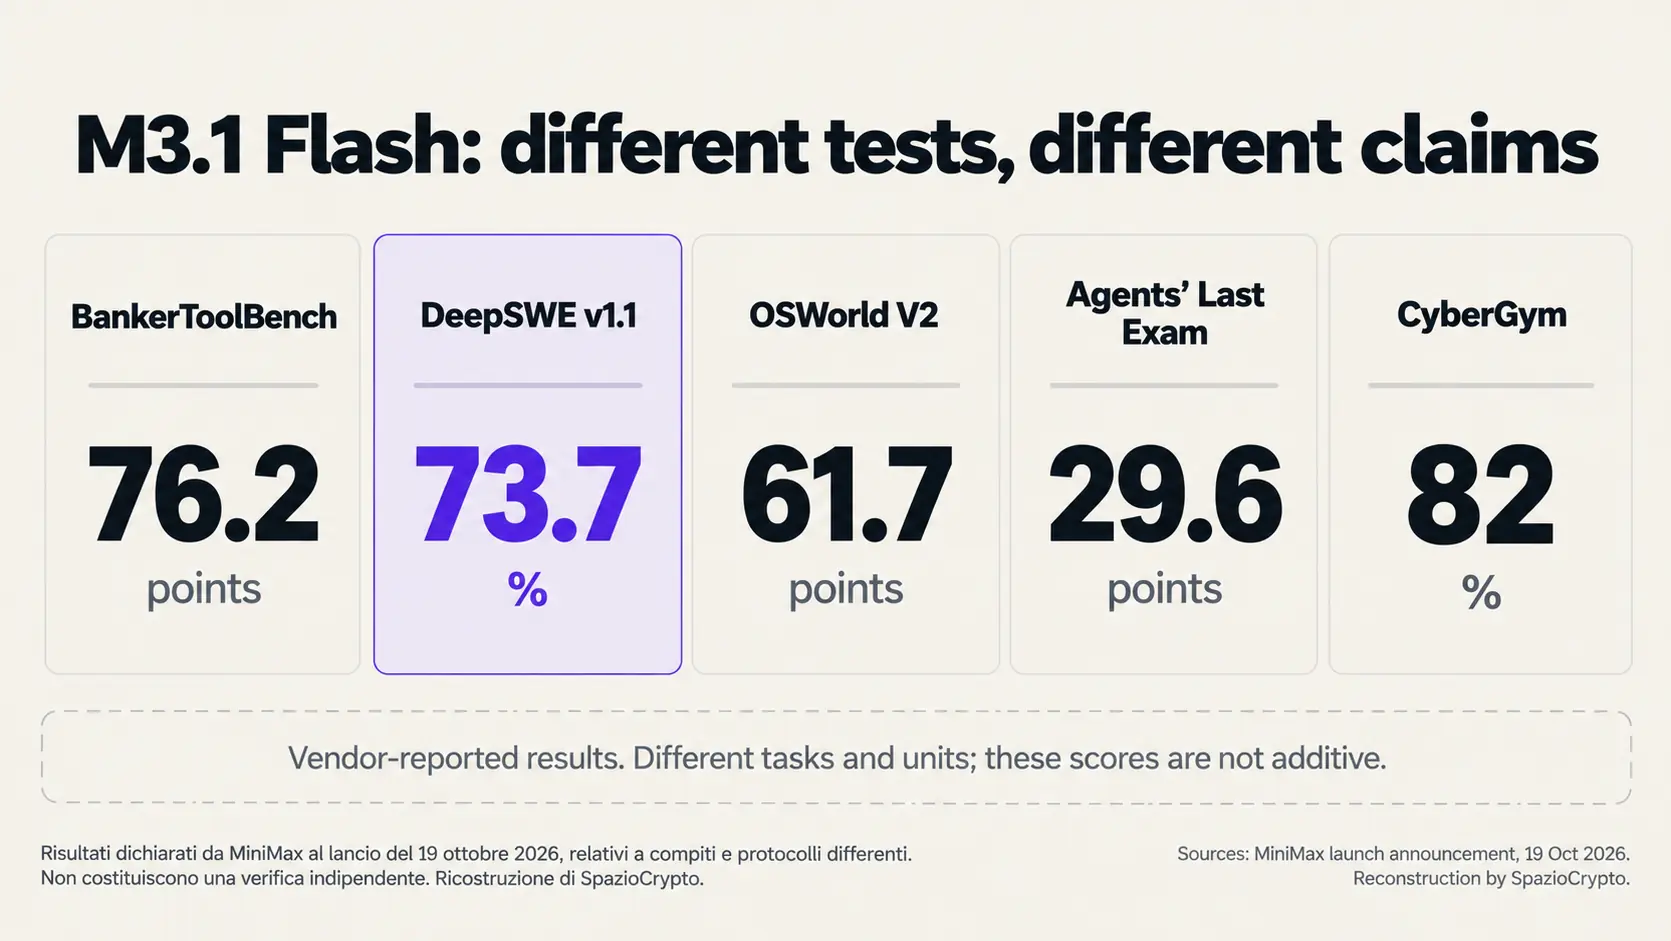
결과적으로, MiniMax는 코딩, 컴퓨터 사용, 보안 분야의 결과를 공개했다. 공식 발표에 따르면 DeepSWE v1.1에서 73.7%, OSWorld V2에서 61.7점, CyberGym에서 82%를 기록했다. 이는 개발사가 직접 제시한 수치다. BankerToolBench에서 76.2점, Agents’ Last Exam에서 29.6점도 함께 발표됐다. 각 테스트는 서로 다른 과제를 측정하며, 이를 합산해 전반적인 신뢰도를 나타내는 단일 수치로 만들 수는 없다. 코딩 문제에서 좋은 결과를 냈다고 해서, 문서나 금융 권한 처리를 오류 없이 수행한다는 근거는 되지 않는다.
속도 수치에도 명확한 맥락이 필요하다. MiniMax 공식 발표에 따르면 특정 조건에서 초당 200토큰 이상, 중앙값 기준으로 170토큰 이상을 기록한다. 이는 자사 인프라 기준 수치로, 모든 절차 완료 시간을 보장하는 것이 아니다. 초당 생성 토큰 수에는 호출 간 대기 시간, 외부 서비스 응답 시간, 결과 검토 작업이 자동으로 포함되지 않는다.
이 구분은 모델 벤치마크 비교에서도 중요하다. 수치에는 반드시 테스트 버전, 허용된 도구, 추론 설정이 함께 명시되어야 한다. Flash 비교 시에는 동일한 목표와 명시된 예산 조건이 전제되어야 한다. 취약점 탐지 능력을 모델의 전반적인 신뢰성 지표로 제시하면, 특정 작업 결과를 다른 모든 활동에 일반화하는 오류가 발생한다.
Artificial Analysis는 별도 벤치마크 스위트를 통해 외부 평가를 제공한다. 해당 기관이 2026년 10월 19일 공개한 포스트에 따르면, Flash는 Intelligence Index에서 42점을 기록했으며 추론 수준은 최고 등급이다. 인덱스 작업당 비용은 약 0.22달러로, M3의 약 0.51달러 대비 절반 이하다. 이는 제조사가 아닌 독립 기관의 평가 결과이며, 해당 기관 인덱스의 작업과 방법론에 한정된 비용이다. 모델에 부여하는 모든 작업에 적용되는 범용 단가가 아니다.
서비스 접근과 가중치 공개는 별개의 단계다
2026년 10월 19일 출시 발표는 세 가지 채널을 명시한다. MiniMax API, M Plan, MiniMax Code가 그것이다. 공식 보도자료는 가중치 공개 일정을 추후로 미뤘지만, MiniMax 공식 LinkedIn 페이지 게시물은 10월 23일을 제시했다. 이는 예고된 일정이지, 이미 완료된 공개가 아니다. 따라서 이용 가능한 서비스와 다운로드 가능한 아티팩트는 여전히 별개의 단계로 남아 있다. Space Bunny를 모델 초기 버전으로 명명한 것은 MiniMax의 자체 발표이며, 익명 명칭이 독립적인 평가를 의미하지는 않는다.
MiniMax-M3.1-Flash scores 42 on the Artificial Analysis Intelligence Index. 13 points higher than MiniMax-M3 and less than half the cost per task. It scores level with GLM-5.3-Flash but behind DeepSeek V4.1 Flash 1017
, Artificial Analysis (@ArtificialAnlys) October 19, 2026
MiniMax-M3.1-Flash is @MiniMax_AI's new Flash reasoning… pic.twitter.com/bEelNegMKP
두 가지 방식은 서로 다른 검증 경로를 제공한다. 호스팅 서비스는 인터페이스와 응답 동작을 즉시 테스트할 수 있게 한다. 가중치 공개는 동반되는 라이선스 조건에 따라 아티팩트 보관과 다양한 설정 연구를 가능하게 한다. 보도자료만으로는 해당 라이선스나 필요 하드웨어를 충분히 설명하지 못한다. 공개 전에 Flash의 완전한 자율 가용성을 전제하는 것은 아직 약속 단계에 있는 절차를 앞서 가정하는 것이다.
유용한 비용 계산은 완료된 작업 기준이다
보조적 코딩에서 에이전트 코딩으로 전환할 때, 비용은 여러 시도에 걸쳐 분산된다. 에이전트는 저장소를 읽고 수정을 제안하고 테스트를 실행한 후 검증 실패 시 코드로 돌아올 수 있다. 이는 Flash에서 측정된 결과가 아닌, 작업 방식을 설명하기 위한 운영 예시다. 경제적 비교는 사용 가능한 솔루션에 도달하지 못한 실행을 포함해, 작업 수락까지의 전체 시퀀스를 기준으로 해야 한다.
독립적 평가의 가치는 그 시퀀스가 얼마나 관찰 가능하고 재현 가능한지에도 달려 있다. 결과 수락 기준을 동일하게 유지하면서 결과, 소비량, 반복 횟수, 수정 사항을 기록하는 방식이 적절하다. 추론 수준을 낮추면 단일 대기 시간은 줄어들고 이후 수정 횟수가 늘어날 수 있다. 이는 선택한 작업 부하에서 검증해야 할 가설이지, 측정 없이 모델에 귀속할 수 있는 확정된 동작이 아니다.
MiniMax M3.1 Flash 요약
- 확인됨: 2026년 10월 19일 출시, 공개 가격표, 호스팅 접근 문서.
- 미확인: LinkedIn에서 발표된 10월 23일 가중치 실제 공개 여부 및 프로세스별 비용 절감 효과.
- 모니터링 필요: 동일 작업 기준 소비량, 필요 수정 횟수, 약속된 아티팩트의 실제 가용성.
더 넓은 시각
경쟁 구도는 응답 단가에서 수용 가능한 작업의 총비용으로 이동하고 있다. Flash의 가격표는 측정 가능한 한 가지 요소를 낮춘다. 결과 검증의 필요성을 없애지는 않는다. 저렴한 모델이 유용해지는 시점은 동일한 요구 결과와 실행 조건에서 수정이 필요한 단계까지 줄일 때다.
앞으로 확인해야 할 구체적 신호는 가중치 공개 일정 준수. 명시적 설정을 갖춘 재현 가능한 비교, 대표적 작업에 대한 측정값이다. 시스템이 실패할 때 어떤 일이 일어나는지도 중요하다. 한계를 신호로 알리는지, 작업을 중단하는지, 아니면 계속 비용을 소모하는지를 살펴야 한다. 이러한 차이는 백만 토큰당 요금만으로는 드러나지 않지만, 신뢰할 수 있는 에이전트의 최종 비용을 결정짓는 요소다.